Le blog Développement EntrepriseIngénierie
IA souveraine en entreprise : construire une application sur mesure avec un modèle privé, hébergé chez vous
IA souveraine en entreprise : une application sur mesure, un modèle privé hébergé chez vous, sans Internet. L'exemple de l'analyse d'appels d'offres.

Points clés de cet article :
- Une IA souveraine, en entreprise, c'est un modèle open-weight installé chez vous ou chez un hébergeur que vous choisissez, que vos données ne quittent pas.
- Les données sensibles sont vos critères, vos cibles, vos prix, vos fiches produits et les décisions de vos équipes.> - Une application d'IA sécurisée sépare la partie qui touche Internet de la partie qui contient vos données, et fait passer les documents de l'une à l'autre par un sas à sens unique.
- Le code calcule tout ce qui peut l'être ; le modèle ne lit que ce qui reste, et chaque réponse cite sa source.
- Le modèle se choisit sur vos propres documents, mesures à l'appui.
Votre entreprise veut mettre l'IA dans un de ses processus : trier des opportunités, lire des documents techniques, rapprocher des fiches produits, préparer une réponse. Vos équipes testent déjà ChatGPT ou Claude sur des documents publics. Le blocage arrive au moment de leur donner ce qui fait la valeur du travail : vos critères de sélection, vos clients, vos tarifs, vos fiches produits, vos contrats. Votre DSI ou votre RSSI refuse que ces données partent chez un fournisseur américain.
Nous construisons pour ce cas des applications métier dans lesquelles le modèle d'IA tourne chez vous, sans accès à Internet, au milieu d'une architecture pensée pour l'isoler. L'exemple déroulé ici est une demande récente : une entreprise qui répond à des appels d'offres voulait que l'IA repère les marchés pertinents pour ses produits, sans que ses critères sortent de chez elle.
Ce que veut dire une IA souveraine en entreprise
Le modèle vous appartient en pratique. C'est un modèle open-weight : son éditeur publie le fichier, vous le téléchargez, vous le faites tourner sur vos machines. Une licence comme Apache 2.0 autorise l'usage commercial et l'installation chez vous sans négociation. Personne ne peut le retirer, le modifier ou changer ses conditions un matin.
Le serveur est sous votre contrôle. Dans vos locaux, ou chez un hébergeur que vous choisissez. Une donnée hébergée en France par une société soumise au droit américain reste exposée au Cloud Act : la qualification SecNumCloud de l'ANSSI répond à cette question, quand elle se pose.
Le modèle n'a pas d'accès à Internet. Il lit ce qu'on lui donne, répond, et ne peut rien envoyer ailleurs. C'est ce qui distingue une IA en local d'un service en ligne « hébergé en Europe ».
L'IA souveraine ne demande pas d'entraîner un modèle. Le modèle s'utilise tel qu'il est publié, ses poids ne changent pas, et vos données ne servent à aucun apprentissage. Ce qui s'adapte à votre métier, c'est l'application autour : les règles, les écrans, les connexions à vos logiciels.
Quand faut-il une IA privée, et quand une API suffit
Toutes les applications d'IA n'ont pas besoin d'un modèle hébergé chez vous. La question se pose sur les données que le modèle va voir.
Une API comme celle de Mistral, d'OpenAI ou d'Anthropic convient quand le modèle ne lit que des contenus publics ou peu sensibles : résumer des articles de presse, rédiger un brouillon de publication, classer des demandes entrantes anonymes. Les offres entreprise de ces éditeurs ne réutilisent pas vos données pour l'entraînement, et le coût se paie à l'usage. Notre article sur l'IA générative en PME détaille ces usages.
Un modèle privé devient nécessaire dès que le modèle doit croiser l'information avec ce qui vous est propre :
- vos critères de sélection, vos segments, vos comptes exclus ;
- vos fiches produits, vos prix, vos marges ;
- vos contrats, vos échanges avec des clients, vos données personnelles ;
- des documents soumis à un engagement de confidentialité.
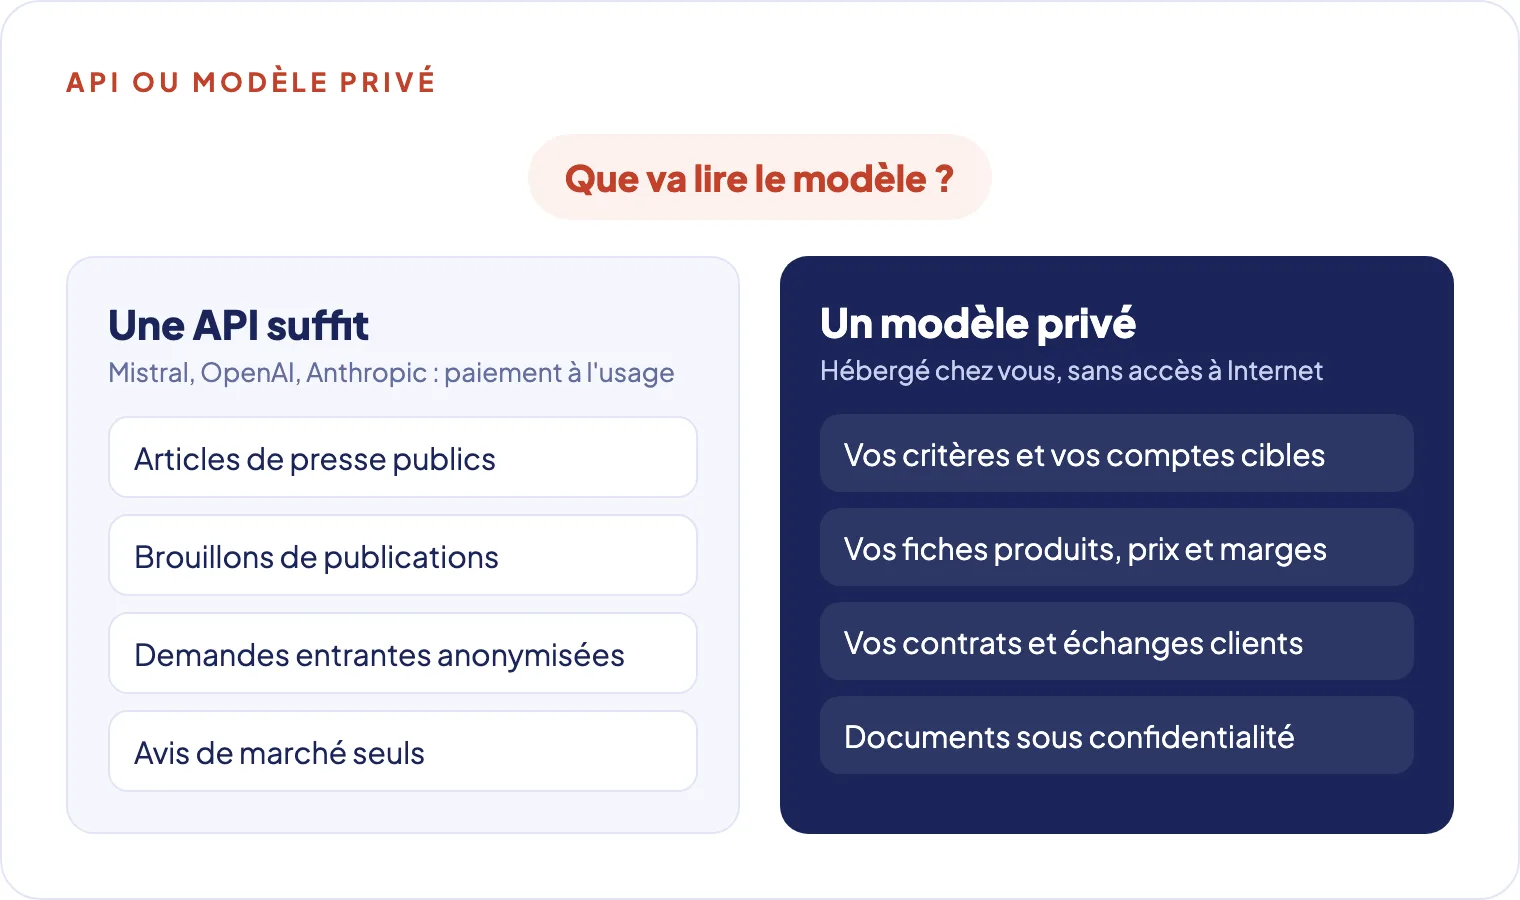
Dans l'exemple des appels d'offres, l'avis de marché est public. Le croiser avec la liste de ce que vous vendez, vos seuils et vos clients cibles révèle votre stratégie commerciale.
La CNIL et l'ANSSI ont publié leurs recommandations sur ces questions. Le choix entre API et modèle privé se tranche au cadrage du projet, donnée par donnée, et se consigne dans votre charte IA.
L'exemple : repérer les appels d'offres qui correspondent à vos produits
Le besoin, tel qu'il nous a été exposé : les commerciaux consultent à la main les plateformes de marchés publics, la presse spécialisée et LinkedIn pour repérer les projets avant leurs concurrents. Chacun a sa méthode, et des opportunités passent. L'entreprise voulait un mail chaque lundi avec les marchés et les projets à étudier, une application pour en consulter le détail, et la certitude que ses critères ne partent chez aucun fournisseur d'IA.
La décision de répondre reste aux commerciaux. L'outil classe les opportunités et explique chaque score.
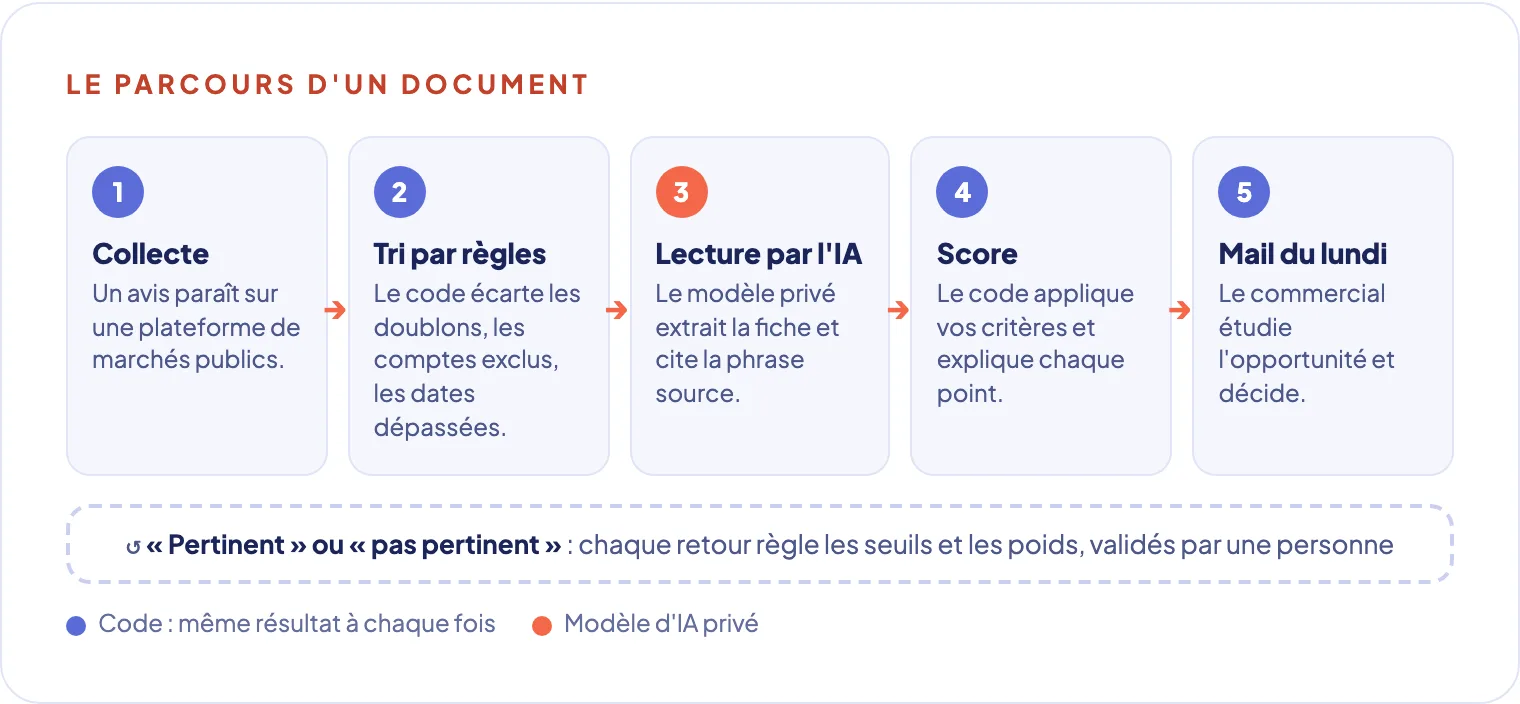
Le même schéma vaut pour une veille de signaux commerciaux, la surveillance de concurrents, le suivi de fins de contrats à renouveler ou la lecture de cahiers des charges : l'IA lit des documents publics, les confronte à vos critères, et une personne décide.
Brancher les sources : API officielles, flux et scraping
La collecte se construit source par source, avec la méthode la plus stable pour chacune.
Les API officielles d'abord. Les marchés publics européens sont accessibles par l'API de TED, les marchés français par les données ouvertes du BOAMP. Les avis se filtrent par codes CPV et par mots-clés du métier. Chaque avis se rattache au même marché tout au long de sa vie : publication, questions, date limite, attribution, fin du contrat et renouvellement.
Les flux RSS de la presse spécialisée ensuite. Pour un article payant, l'outil lit la partie publique.
Le scraping, quand il n'existe ni API ni flux. Pages d'actualités de salons professionnels, listes d'exposants, pages d'acheteurs : l'outil repasse à heures fixes et détecte ce qui a changé depuis le dernier passage. Chaque page se choisit avec vous et se teste avant d'entrer en production, en respectant les conditions d'utilisation du site.
LinkedIn, par le compte d'un commercial. Un service comme Unipile connecte le compte d'un commercial volontaire et relit ses relations sous des plafonds journaliers bas, sans envoyer ni invitation ni message. Les conditions d'utilisation de LinkedIn interdisent l'automatisation, et le compte connecté peut être restreint : l'outil continue de fonctionner sans cette source. Vos critères ne passent ni par Unipile ni par LinkedIn : le rapprochement entre une entreprise repérée et vos relations se fait dans la zone privée. Nous utilisons la même mécanique dans notre offre de relance des relations LinkedIn et CRM.
Avant de transmettre quoi que ce soit, la collecte écarte ce qui a déjà été lu, les avis republiés et les documents hors langue. Ce tri limite le volume de texte confié au modèle, donc la taille du serveur d'IA.
Architecture d'une IA sécurisée : zones séparées et sas
La partie qui touche Internet ne contient aucune de vos données ; la partie qui les contient n'a pas accès à Internet.
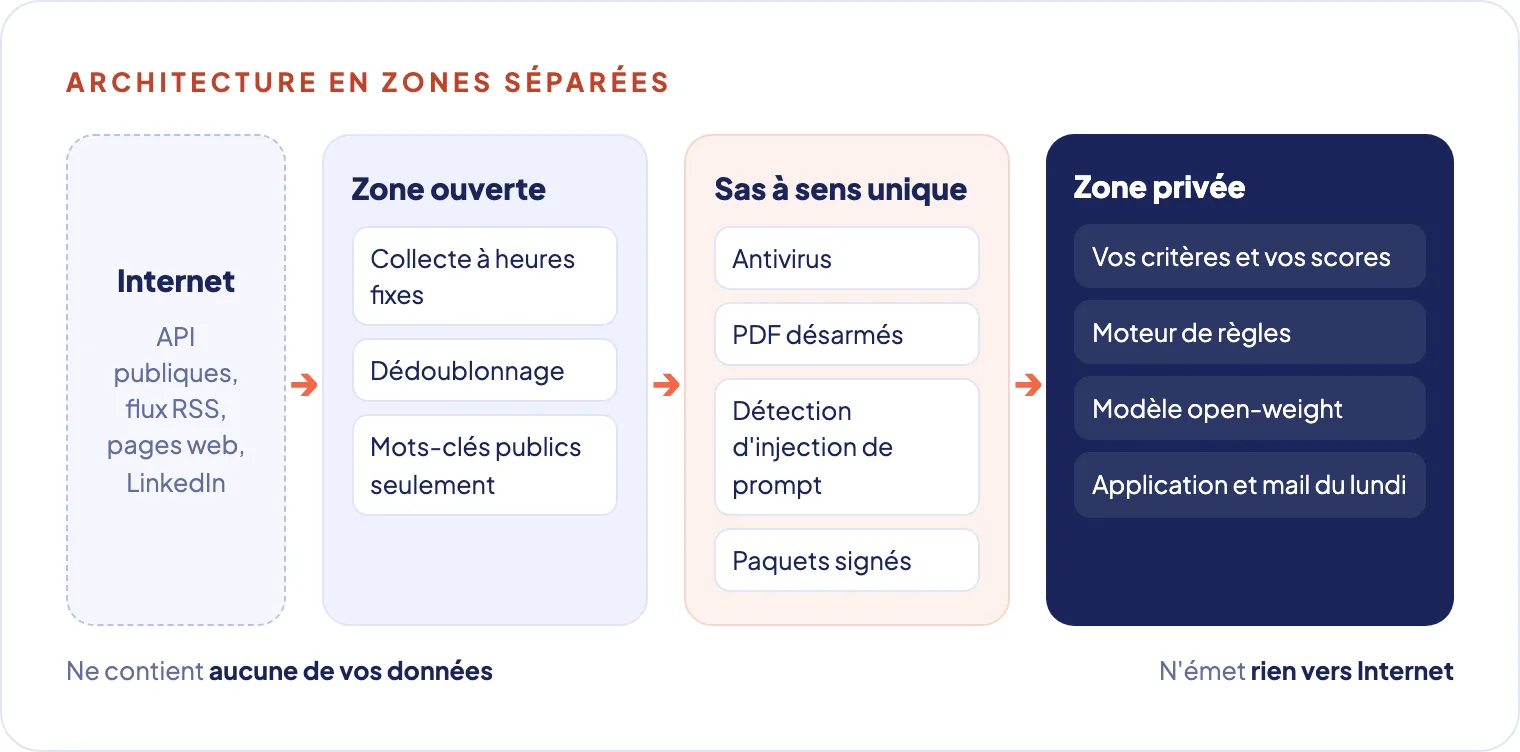
La zone ouverte collecte. Un petit serveur, hébergé en France, relève les sources. Il ne connaît que des mots-clés publics du métier, jamais vos critères ni vos cibles.
Le sas fait passer les documents dans un seul sens. Tout document venu d'Internet est traité comme suspect :
- antivirus sur chaque fichier, quarantaine pour un fichier douteux ;
- désarmement des PDF : chaque document est converti en images puis en texte dans un conteneur sans réseau, sur le principe de l'outil open source Dangerzone. Scripts, liens, macros et pièces jointes disparaissent ; seul le texte passe ;
- détection des injections de prompt, ces textes écrits pour détourner un modèle d'IA. Un texte suspect part en quarantaine et reste visible dans le journal, où un administrateur peut le relire ;
- paquets signés, vérifiés à l'entrée. La zone privée n'émet rien vers Internet. Si votre DSI dispose d'une diode réseau, elle se place à cet endroit.
La zone privée décide. Elle contient la base de données, le moteur de règles, le modèle d'IA et l'application web. Elle s'installe chez vous ou chez votre hébergeur, sans accès à Internet. Vos équipes la consultent depuis votre réseau, avec une double authentification ; le mail du lundi part par votre messagerie interne. Les mises à jour arrivent par un dépôt miroir contrôlé, empreintes vérifiées.
Nos interventions passent par votre bastion, avec des comptes nominatifs et des sessions tracées.
Comment l'outil note une opportunité selon vos critères
Vos critères deviennent des règles typées. Une plage de valeurs (une quantité, un montant), un choix dans une liste, des mots-clés, un oui ou non. Le code les calcule, avec le même résultat à chaque fois et sans coût de calcul d'IA. Les comptes exclus et les dates limites dépassées sont écartés avant toute lecture par le modèle.
Le modèle lit ce qui reste. Il tire de chaque document une fiche : l'acheteur, l'objet, les caractéristiques techniques, les échéances, avec la phrase d'origine qui justifie chaque valeur. Un article en langue étrangère est lu et présenté en français. La réponse du modèle passe par un schéma de validation avant d'être enregistrée, et le code vérifie que la citation figure mot pour mot dans le texte source.
Les critères partent de vos fiches produits. Vous déposez vos documents techniques, vos références d'installation, les mails qui fixent ce que vous cherchez. Le modèle privé les lit et propose des critères, chacun avec la phrase et le document dont il vient. Un critère proposé reste inactif tant qu'une personne ne l'a pas validé.
Le score s'explique. La fiche affiche la part de chaque critère dans le score, avec ses seuils rouge et vert. Sur chaque ligne du mail du lundi, le commercial répond « pertinent » ou « pas pertinent » ; une opportunité perdue ou écartée demande un motif. Ces retours servent à régler les seuils et les poids, et chaque changement est validé par une personne.
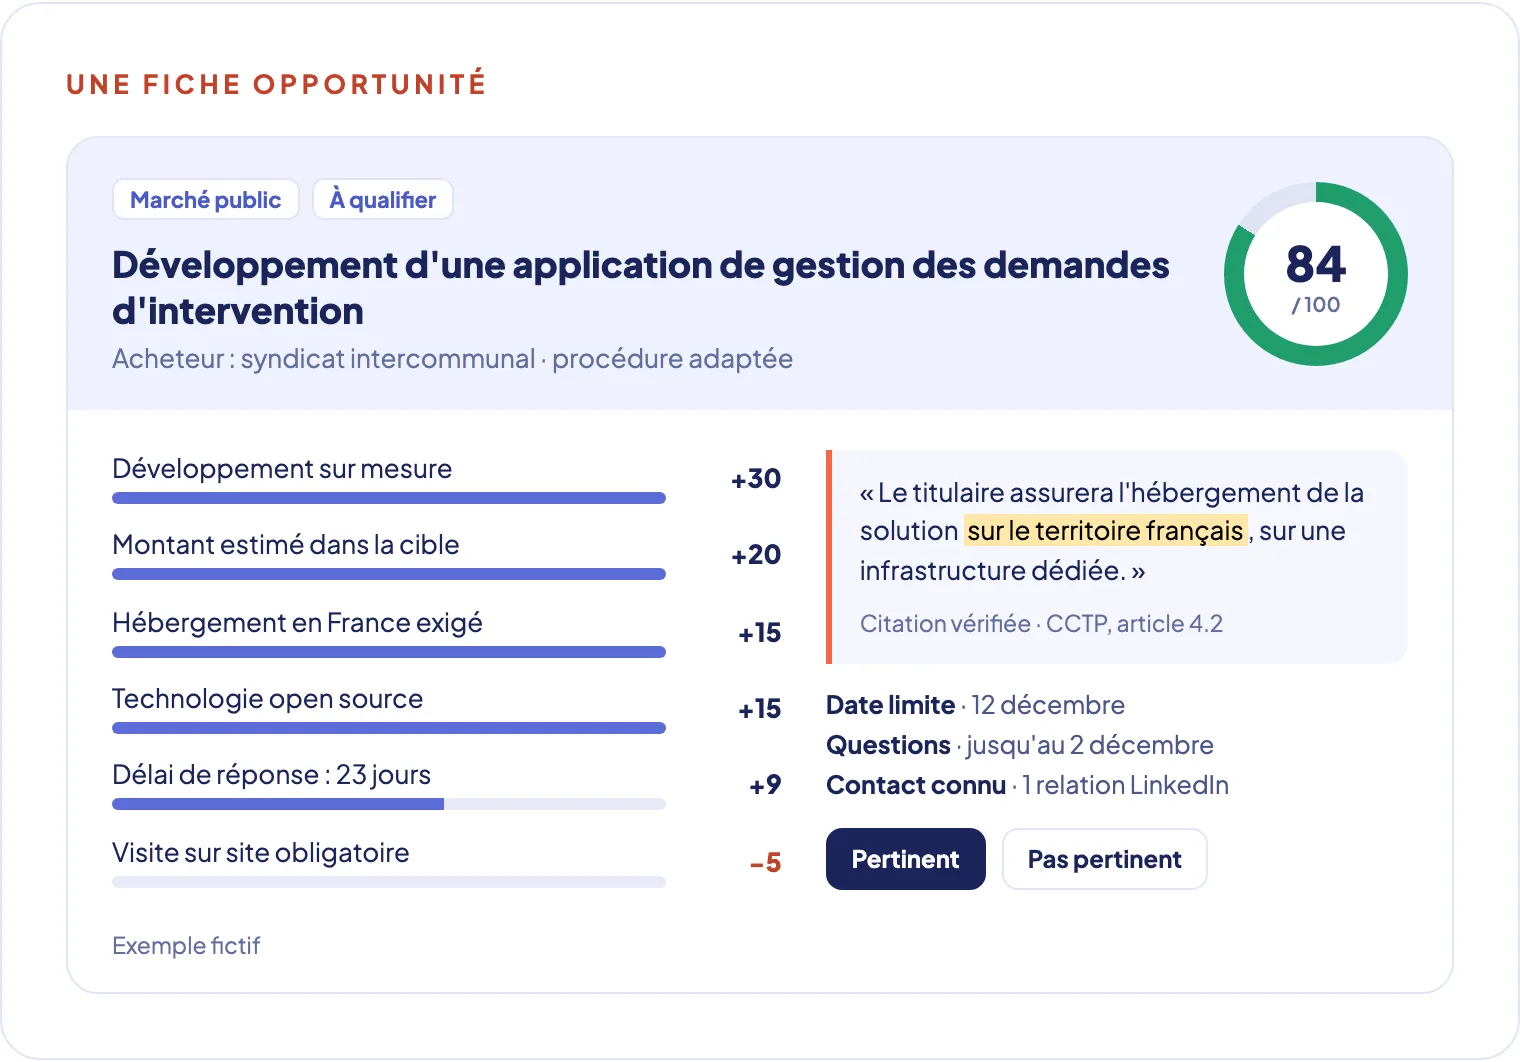
C'est le même principe que dans notre chatbot branché sur une base de données : la sécurité et la justesse tiennent à l'architecture, la qualité du modèle vient après.
Quel LLM open source héberger en local en 2026
Le modèle est servi par vLLM, un serveur open source, derrière une interface interne à la zone privée. Changer de modèle ne change pas l'application.
Les modèles open-weight que nous comparons pour un serveur à une carte de 48 Go, relevés en novembre 2026 :
| Modèle | Éditeur | Licence | Sur une carte de 48 Go |
|---|---|---|---|
| Mistral Small 3.2, 24 milliards de paramètres | Mistral AI (France) | Apache 2.0 | oui, quantifié en FP8 |
| Luciole 23B, juillet 2026 | OpenLLM France (France) | Apache 2.0 | oui, quantifié en FP8 |
| Olala mini 7A1B, novembre 2026 | OVHcloud (France) | Apache 2.0 | oui, 8 Go suffisent |
| Gemma 4 31B, avril 2026 | Google (États-Unis) | Apache 2.0 | oui, quantifié en 8 bits |
| Granite 4.2 30B, août 2026 | IBM (États-Unis) | Apache 2.0 | oui, quantifié en FP8 |
| Muse Glimmer 30B, août 2026 | Meta (États-Unis) | Apache 2.0 | oui, quantifié en 8 bits |
| Qwen3.8 27B, août 2026 | Alibaba (Chine) | Apache 2.0 | oui, quantifié en FP8 |
Un éditeur français et une licence libre font de Mistral Small 3.2 notre premier choix pour des documents en français et en anglais. Luciole, entraîné en France sur des données ouvertes, est l'alternative pour qui veut un modèle européen de bout en bout.
Olala mini, le premier modèle d'OVHcloud, annoncé le 17 novembre 2026, est un mélange d'experts de 7 milliards de paramètres dont un seul milliard travaille à chaque mot. Il tourne avec 8 Go de mémoire graphique, voire sur un processeur, ce qui le rend très peu coûteux à héberger. Nous le réservons aux tâches simples (tri, classement, résumé court) en attendant de le mesurer sur l'extraction de fiches.
Les modèles chinois comme Qwen tournent eux aussi entièrement chez vous, sans aucun échange avec leur éditeur. Certaines entreprises les écartent malgré tout par principe : le choix se tranche avec votre RSSI. Les plus gros modèles ouverts, comme Mistral Small 4 (119 milliards de paramètres) ou Mistral Large 4, demandent plusieurs cartes de 80 Go. OpenAI publie aussi gpt-oss-20b, léger mais moins documenté en français.
Les poids se téléchargent depuis la source de l'éditeur, leur empreinte est vérifiée, et seul le format safetensors est accepté.
Pour le serveur, une carte de 48 Go suffit à un premier outil. Ordres de grandeur relevés sur les tarifs publics en novembre 2026 :
- serveur dans vos locaux avec une carte L40S : achat du matériel, selon votre DSI ;
- GPU dédié chez un hébergeur français : environ 1 200 à 1 500 € HT par mois ;
- hébergement qualifié SecNumCloud : environ 1 500 à 3 000 € HT par mois.
Nous vous aidons à choisir l'offre, installons le modèle et assurons ensuite l'exploitation de l'application : supervision, sauvegardes, mises à jour de sécurité.
Mesurer la qualité avant de choisir le modèle
Le choix du modèle se fait sur vos documents. Avec vos équipes, nous constituons un jeu d'évaluation : de vrais documents, annotés à la main (pertinent ou non, valeur attendue de chaque critère). Chaque modèle candidat est mesuré critère par critère :
- la précision : la part des opportunités retenues à tort ;
- le rappel : la part des opportunités manquées ;
- les valeurs mal extraites : une quantité, une date, un montant faux.
Des tests de robustesse vérifient sa tenue face aux injections de prompt et aux documents piégés. Le modèle retenu est celui qui donne le meilleur résultat sur votre matériel, choisi avec votre équipe cyber. Le même jeu se rejoue après chaque changement de critère ou de modèle, et chaque mois ensuite.
Autres usages d'une IA privée sur mesure
La même architecture sert dès qu'une entreprise veut confier à l'IA un travail sur des données qu'elle ne peut pas exposer.
- Lire des fiches produits complexes et en extraire des caractéristiques comparables, pour un configurateur ou un simulateur d'aide à la vente ou pour un catalogue structuré.
- Comparer des contrats ou des cahiers des charges avec vos modèles internes, clause par clause.
- Repérer des économies dans vos contrats fournisseurs, vos achats ou vos abonnements, en les confrontant à vos conditions habituelles.
- Chercher des partenaires ou des fournisseurs à partir de critères techniques que vous ne publiez pas.
- Connecter l'IA à vos logiciels par des serveurs MCP, ces connecteurs qui donnent à un agent un accès encadré à votre ERP, à votre CRM ou à votre base documentaire, comme nous l'avons fait pour préparer nos devis à partir de nos réunions. Chaque connecteur s'audite avant d'être installé, comme un skill ou un plugin IA.
- Construire votre propre plateforme d'IA, avec vos utilisateurs, vos droits d'accès et vos modèles, quand vous voulez proposer l'IA à vos équipes ou à vos clients sans dépendre d'un éditeur. Nous l'accompagnons du MVP au produit.
Selon les données en jeu, une même application peut mêler un modèle privé pour ce qui est sensible et une API pour le reste. Ce découpage se décide au cadrage, avec votre DSI.
Construire votre application d'IA souveraine avec nous
Nous concevons et développons l'application complète : la collecte, le sas, la zone privée, le moteur de règles, les écrans, le mail, l'installation du modèle et sa mesure. Nous la construisons en Symfony, notre technologie depuis 2014, avec des tests à chaque modification. Le code vous est cédé au fur et à mesure des paiements, dans un dépôt à votre nom, et la documentation vit avec lui : vos équipes peuvent le reprendre.
- Pour commencer par l'inventaire de vos processus et des données qu'ils touchent : le diagnostic et la feuille de route IA.
- Pour un agent qui lit et écrit dans vos logiciels : les agents IA connectés au système d'information.
- Pour une application métier construite autour de l'IA : la conception d'application métier.
- Pour les règles, les journaux et les preuves à présenter à votre RSSI : la gouvernance, traçabilité et conformité IA.
- Pour faire évoluer l'outil chaque mois, avec un product owner dédié : l'agence d'automatisation IA sur abonnement.
Vos équipes apprennent à s'en servir et à construire leurs propres assistants avec la formation IA opérationnelle.
Questions fréquentes
Qu'est-ce qu'une IA souveraine ?
Un modèle d'IA que vous faites tourner sur des serveurs que vous contrôlez, dans vos locaux ou chez un hébergeur choisi, sans que vos données passent par un éditeur étranger. En pratique, un modèle open-weight sous licence libre, servi dans une zone privée sans accès à Internet.
Peut-on faire tourner une IA en local, sans Internet ?
Oui. Un modèle open-weight se télécharge une fois, son empreinte se vérifie, et il tourne ensuite sur un serveur coupé d'Internet. Les mises à jour arrivent par un dépôt miroir contrôlé.
Faut-il entraîner un modèle sur ses propres données ?
Non. Le modèle s'utilise tel qu'il est publié. Votre métier entre dans l'application par les règles, les critères tirés de vos documents et les retours de vos équipes, qui règlent les seuils et les poids.
Un modèle open-weight est-il aussi bon que ChatGPT ?
Sur une tâche précise, comme extraire des valeurs d'un document ou classer une opportunité selon des critères, un modèle de 24 à 30 milliards de paramètres donne de bons résultats quand le code a déjà fait le tri. Le choix se mesure sur vos documents, avec la précision et le rappel, avant la mise en service.
vLLM ou Ollama pour héberger un LLM ?
vLLM pour un serveur partagé : il traite les requêtes de plusieurs utilisateurs en parallèle, tire le meilleur parti de la carte graphique et expose une API compatible avec celle d'OpenAI. Ollama pour un poste de travail ou une maquette : il s'installe en une commande et fait tourner un modèle sur un portable. L'application parle à une interface interne, et passer de l'un à l'autre ne la change pas.
Combien coûte le serveur d'un modèle privé ?
Une carte graphique de 48 Go suffit : environ 1 200 à 1 500 € HT par mois chez un hébergeur français, 1 500 à 3 000 € HT en hébergement qualifié SecNumCloud, ou un achat pour vos locaux.
Le scraping est-il légal ?
La collecte de données publiques est possible en respectant les conditions d'utilisation de chaque site et le RGPD pour les données personnelles. Nous privilégions les API officielles et les flux RSS. Les conditions d'utilisation de LinkedIn interdisent l'automatisation : sa lecture passe par le compte d'un utilisateur volontaire, sous des plafonds bas, et l'outil fonctionne sans elle.
Vous avez un processus où l'IA ferait gagner du temps, et des données qui ne doivent pas sortir de chez vous ? Décrivez-nous votre besoin, et nous commençons par la carte des données que le modèle verra.
À lire ensuite
Tous les articles →


Vous vous posez la même question ?
Racontez-nous votre situation. On vous dira dans le même échange si c'est un sujet pour nous, et par quoi on commencerait.
ou choisissez un créneau tout de suite, ou appelez le 06 01 91 57 40